写在前面
原论文:Harnessing Smoothness to Accelerate Distributed Optimization.
本文是Qu 2018的笔记,主要是对离散系统分布式梯度跟踪算法证明过程的总结。
问题描述和算法
问题描述
min x ∈ R d f ( x ) = 1 n ∑ i = 1 n f i ( x ) \min_{x\in\mathbb R^d} f(x)=\frac{1}{n}\sum_{i=1}^n f_i(x)
x ∈ R d min f ( x ) = n 1 i = 1 ∑ n f i ( x )
假设1:f i f_i f i α \alpha α β \beta β
f i ( y ) − f i ( x ) ≥ ∇ f i ( x ) T ( y − x ) + α 2 ∥ y − x ∥ 2 ∥ ∇ f i ( x ) − ∇ f i ( y ) ∥ ≤ β ∥ x − y ∥ \begin{aligned}
f_i(y)-f_i(x)&\geq \nabla f_i(x)^T(y-x)+\frac{\alpha}{2}\|y-x\|^2\\
\|\nabla f_i(x)-\nabla f_i(y)\|&\leq \beta\|x-y\|
\end{aligned}
f i ( y ) − f i ( x ) ∥ ∇ f i ( x ) − ∇ f i ( y ) ∥ ≥ ∇ f i ( x ) T ( y − x ) + 2 α ∥ y − x ∥ 2 ≤ β ∥ x − y ∥
离散系统分布式优化算法
x i ( t + 1 ) = ∑ i = 1 n w i j x j ( t ) − η s i ( t ) s i ( t + 1 ) = ∑ j = 1 n w i j s j ( t ) + ∇ f i ( x i ( t + 1 ) ) − ∇ f i ( x i ( t ) ) ( 1 ) \begin{aligned}
x_i(t+1)&=\sum_{i=1}^nw_{ij}x_j(t)-\eta s_i(t)\\
s_i(t+1)&=\sum_{j=1}^nw_{ij}s_j(t)+\nabla f_i(x_i(t+1))-\nabla f_i(x_i(t))
\end{aligned}\qquad (1)
x i ( t + 1 ) s i ( t + 1 ) = i = 1 ∑ n w i j x j ( t ) − η s i ( t ) = j = 1 ∑ n w i j s j ( t ) + ∇ f i ( x i ( t + 1 ) ) − ∇ f i ( x i ( t ) ) ( 1 )
其中x i ( t ) ∈ R 1 × d x_i(t)\in \mathbb R^{1\times d} x i ( t ) ∈ R 1 × d s i ( t ) ∈ R 1 × d s_i(t)\in \mathbb R^{1\times d} s i ( t ) ∈ R 1 × d s i ( 0 ) = ∇ f i ( x i ( 0 ) ) s_i(0)=\nabla f_i(x_i(0)) s i ( 0 ) = ∇ f i ( x i ( 0 ) ) s i ( t ) s_i(t) s i ( t ) 1 n ∇ f i ( x i ( t ) ) \frac{1}{n}\nabla f_i(x_i(t)) n 1 ∇ f i ( x i ( t ) ) 分布式梯度跟踪法 (distributed gradient tracking, DGT)。
收敛性证明
给定W W W 双随机 (doubly stochastic)矩阵。算法(1)矩阵形式
x ( t + 1 ) = W x ( t ) − η s ( t ) s ( t + 1 ) = W s ( t ) + ∇ ( t + 1 ) − ∇ ( t ) ( 2 ) \begin{aligned}
x(t+1)&=W x(t)-\eta s(t)\\
s(t+1)&=W s(t)+\nabla(t+1)-\nabla (t)
\end{aligned}\qquad (2)
x ( t + 1 ) s ( t + 1 ) = W x ( t ) − η s ( t ) = W s ( t ) + ∇ ( t + 1 ) − ∇ ( t ) ( 2 )
其中s ( 0 ) = ∇ ( 0 ) s(0)=\nabla (0) s ( 0 ) = ∇ ( 0 ) ∇ ∈ R n × d \nabla\in\mathbb R^{n\times d} ∇ ∈ R n × d ∇ f i ( x i ( t ) ) \nabla f_i(x_i(t)) ∇ f i ( x i ( t ) ) x ∈ R n × d x\in\mathbb R^{n\times d} x ∈ R n × d s ∈ R n × d s\in\mathbb R^{n\times d} s ∈ R n × d
令x ˉ ( t ) = ( 1 / n ) 1 n T x ( t ) \bar x(t)=(1/n)1_n^T x(t) x ˉ ( t ) = ( 1 / n ) 1 n T x ( t ) s ˉ ( t ) = ( 1 / n ) 1 n T s ( t ) \bar s(t)=(1/n)1_n^T s(t) s ˉ ( t ) = ( 1 / n ) 1 n T s ( t ) g ( t ) = ( 1 / n ) 1 n T ∇ ( t ) g(t)=(1/n)1_n^T \nabla(t) g ( t ) = ( 1 / n ) 1 n T ∇ ( t )
引理1(Lemma 7):以下等式成立:
s ˉ ( t + 1 ) = s ˉ ( t ) + g ( t + 1 ) − g ( t ) = g ( t + 1 ) \bar s(t+1)=\bar s(t)+g(t+1)-g(t)=g(t+1) s ˉ ( t + 1 ) = s ˉ ( t ) + g ( t + 1 ) − g ( t ) = g ( t + 1 ) x ˉ ( t + 1 ) = x ˉ ( t ) − η s ˉ ( t ) = x ˉ ( t ) − η g ( t ) \bar x(t+1)=\bar x(t)-\eta \bar s(t)=\bar x(t)-\eta g(t) x ˉ ( t + 1 ) = x ˉ ( t ) − η s ˉ ( t ) = x ˉ ( t ) − η g ( t )
证明:式(2)中两边同乘( 1 / n ) 1 n T (1/n)1_n^T ( 1 / n ) 1 n T g ( t ) = s ˉ ( t ) = ( 1 / n ) 1 n T s ( t ) g(t)=\bar s(t)=(1/n)1_n^T s(t) g ( t ) = s ˉ ( t ) = ( 1 / n ) 1 n T s ( t ) s ( 0 ) = ∇ ( 0 ) s(0)=\nabla (0) s ( 0 ) = ∇ ( 0 ) x ˉ ( t + 1 ) = x ˉ ( t ) − η g ( t ) \bar x(t+1)=\bar x(t)-\eta g(t) x ˉ ( t + 1 ) = x ˉ ( t ) − η g ( t )
下面证明收敛性,证明思路是分别证明梯度跟踪误差 、一致性误差 和最优解误差 的收敛性,最后证明目标误差 的收敛性。
第一步,先看梯度跟踪误差 ∥ s ( k ) − 1 n g ( k ) ∥ \|s(k)-1_ng(k)\| ∥ s ( k ) − 1 n g ( k ) ∥
s ( k ) − 1 n g ( k ) = [ W s ( k − 1 ) − 1 n g ( k − 1 ) ] + [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] . ( 3 ) s(k)-1_ng(k)=[W s(k-1)-1_ng(k-1)]+[\nabla(k)-\nabla(k-1)]-1_n[g(k)-g(k-1)].\qquad (3)
s ( k ) − 1 n g ( k ) = [ W s ( k − 1 ) − 1 n g ( k − 1 ) ] + [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] . ( 3 )
令σ ∈ ( 0 , 1 ) \sigma\in(0,1) σ ∈ ( 0 , 1 ) W − ( 1 / n ) 1 n 1 n T W-(1/n)1_n1_n^T W − ( 1 / n ) 1 n 1 n T 谱范数 (spectral norm)。对任意ω ∈ R n \omega\in \mathbb R^n ω ∈ R n
∥ W ω − ( 1 / n ) 1 n 1 n T ω ∥ = ∥ ( W − ( 1 / n ) 1 n 1 n T ) ( ω − ( 1 / n ) 1 n 1 n T ω ) ∥ ≤ σ ∥ ω − ( 1 / n ) 1 n 1 n T ω ∥ . ( 4 ) \|W\omega-(1/n)1_n1_n^T \omega\|=\|(W-(1/n)1_n1_n^T)(\omega-(1/n)1_n1_n^T \omega)\|\leq \sigma\|\omega-(1/n)1_n1_n^T \omega\|.\qquad (4)
∥ W ω − ( 1 / n ) 1 n 1 n T ω ∥ = ∥ ( W − ( 1 / n ) 1 n 1 n T ) ( ω − ( 1 / n ) 1 n 1 n T ω ) ∥ ≤ σ ∥ ω − ( 1 / n ) 1 n 1 n T ω ∥ . ( 4 )
由式(4)和引理1,式(3)可以取范数得到
∥ s ( k ) − 1 n g ( k ) ∥ ≤ ∥ W s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ ≤ σ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ . ( 5 ) \begin{aligned}
\|s(k)-1_ng(k)\|&\leq \|Ws(k-1)-1_ng(k-1)\|+\|[\nabla(k)-\nabla(k-1)]-1_n[g(k)-g(k-1)]\|\\
&\leq \sigma\|s(k-1)-1_ng(k-1)\|+\|[\nabla(k)-\nabla(k-1)]-1_n[g(k)-g(k-1)]\|.
\end{aligned}\qquad (5)
∥ s ( k ) − 1 n g ( k ) ∥ ≤ ∥ W s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ ≤ σ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ . ( 5 )
式(5)后半部分可得
∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ 2 = ∥ ∇ ( k ) − ∇ ( k − 1 ) ∥ 2 + ∥ ( 1 / n ) 1 n 1 n T ( ∇ ( k ) − ∇ ( k − 1 ) ) ∥ 2 − ( ∇ ( k ) − ∇ ( k − 1 ) ) T ( 1 / n ) 1 n 1 n T ( ∇ ( k ) − ∇ ( k − 1 ) ) ≤ ∥ ∇ ( k ) − ∇ ( k − 1 ) ∥ 2 . \begin{aligned}
\|[\nabla(k)-\nabla(k-1)]-1_n[g(k)-g(k-1)]\|^2&=\|\nabla(k)-\nabla(k-1)\|^2+\|(1/n)1_n1_n^T(\nabla (k)-\nabla(k-1))\|^2\\
&\quad -(\nabla(k)-\nabla(k-1))^T(1/n)1_n1_n^T(\nabla (k)-\nabla(k-1))\\
&\leq \|\nabla(k)-\nabla(k-1)\|^2.
\end{aligned}
∥ [ ∇ ( k ) − ∇ ( k − 1 ) ] − 1 n [ g ( k ) − g ( k − 1 ) ] ∥ 2 = ∥ ∇ ( k ) − ∇ ( k − 1 ) ∥ 2 + ∥ ( 1 / n ) 1 n 1 n T ( ∇ ( k ) − ∇ ( k − 1 ) ) ∥ 2 − ( ∇ ( k ) − ∇ ( k − 1 ) ) T ( 1 / n ) 1 n 1 n T ( ∇ ( k ) − ∇ ( k − 1 ) ) ≤ ∥ ∇ ( k ) − ∇ ( k − 1 ) ∥ 2 .
代入(3)再结合假设1得到
∥ s ( k ) − 1 n g ( k ) ∥ ≤ σ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ∥ x ( k ) − x ( k − 1 ) ∥ . ( 6 ) \|s(k)-1_ng(k)\|\leq \sigma\|s(k-1)-1_ng(k-1)\|+\beta\|x(k)-x(k-1)\|.\qquad (6)
∥ s ( k ) − 1 n g ( k ) ∥ ≤ σ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ∥ x ( k ) − x ( k − 1 ) ∥ . ( 6 )
第二步,同样的,一致性误差 由式(4)可得
∥ x ( k ) − 1 n x ˉ ( k ) ∥ = ∥ W x ( k − 1 ) − η s ( k − 1 ) − x ˉ ( k − 1 ) + η 1 n g ( k − 1 ) ∥ ≤ σ ∥ x ( k − 1 ) − x ˉ ( k − 1 ) ∥ + η ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ ( 7 ) \begin{aligned}
\|x(k)-1_n\bar x(k)\|&= \|Wx(k-1)-\eta s(k-1)-\bar x(k-1)+\eta1_n g(k-1)\|\\
&\leq \sigma\|x(k-1)-\bar x(k-1)\|+\eta\|s(k-1)-1_ng(k-1)\|
\end{aligned}\qquad (7)
∥ x ( k ) − 1 n x ˉ ( k ) ∥ = ∥ W x ( k − 1 ) − η s ( k − 1 ) − x ˉ ( k − 1 ) + η 1 n g ( k − 1 ) ∥ ≤ σ ∥ x ( k − 1 ) − x ˉ ( k − 1 ) ∥ + η ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ ( 7 )
定义f = 1 n ∑ i = 1 n f i f=\frac{1}{n}\sum_{i=1}^n f_i f = n 1 ∑ i = 1 n f i x ˉ ( t ) \bar x(t) x ˉ ( t ) h ( t ) = ∇ f ( x ˉ ( t ) ) ∈ R n × d h(t)=\nabla f(\bar x(t))\in\mathbb R^{n\times d} h ( t ) = ∇ f ( x ˉ ( t ) ) ∈ R n × d
第三步,再看最优解误差 ∥ x ˉ − x ∗ ∥ \|\bar x-x^*\| ∥ x ˉ − x ∗ ∥
x ˉ ( k ) = x ˉ ( k − 1 ) − η h ( k − 1 ) − η [ g ( k − 1 ) − h ( k − 1 ) ] . ( 8 ) \bar x(k)=\bar x(k-1)-\eta h(k-1)-\eta[g(k-1)-h(k-1)].\qquad (8)
x ˉ ( k ) = x ˉ ( k − 1 ) − η h ( k − 1 ) − η [ g ( k − 1 ) − h ( k − 1 ) ] . ( 8 )
引理2(Lemma 3.11 ):如果f : R d → R f:\mathbb R^d\to\mathbb R f : R d → R ∀ x , y ∈ R d \forall x,y\in\mathbb R^d ∀ x , y ∈ R d
( ∇ f ( x ) − ∇ f ( y ) ) T ( x − y ) ≥ α β α + β ∥ x − y ∥ 2 + 1 α + β ∥ ∇ f ( x ) − ∇ f ( y ) ∥ 2 . (\nabla f(x)-\nabla f(y))^T(x-y)\geq \frac{\alpha\beta}{\alpha+\beta}\|x-y\|^2+\frac{1}{\alpha+\beta}\|\nabla f(x)-\nabla f(y)\|^2.
( ∇ f ( x ) − ∇ f ( y ) ) T ( x − y ) ≥ α + β α β ∥ x − y ∥ 2 + α + β 1 ∥ ∇ f ( x ) − ∇ f ( y ) ∥ 2 .
引理3:∀ x ∈ R d \forall x\in\mathbb R^d ∀ x ∈ R d x + = x − η ∇ f ( x ) x^+=x-\eta \nabla f(x) x + = x − η ∇ f ( x ) 0 < η < 2 β 0<\eta<\frac{2}{\beta} 0 < η < β 2 f f f
∥ x + − x ∗ ∥ ≤ λ ∥ x − x ∗ ∥ \|x^+-x^*\|\leq \lambda \|x-x^*\|
∥ x + − x ∗ ∥ ≤ λ ∥ x − x ∗ ∥
其中λ = max ( ∣ 1 − η α ∣ , ∣ 1 − η β ∣ ) \lambda =\max(|1-\eta \alpha|,|1-\eta \beta|) λ = max ( ∣ 1 − η α ∣ , ∣ 1 − η β ∣ )
证明:如果0 < η ≤ 2 α + β 0<\eta\leq \frac{2}{\alpha+\beta} 0 < η ≤ α + β 2 α < β \alpha< \beta α < β 2 η − α ≥ β \frac{2}{\eta}-\alpha\geq\beta η 2 − α ≥ β ∣ 1 − η α ∣ ≥ ∣ 1 − η β ∣ |1-\eta\alpha|\geq |1-\eta\beta| ∣ 1 − η α ∣ ≥ ∣ 1 − η β ∣ f f f 2 η − α \frac{2}{\eta}-\alpha η 2 − α
∥ x − x ∗ − η ∇ f ( x ) ∥ 2 = ∥ x − x ∗ ∥ 2 + η 2 ∥ ∇ f ( x ) ∥ 2 − 2 η ∇ f ( x ) T ( x − x ∗ ) ≤ ( 1 − 2 η α ( 2 η − α ) α + ( 2 η − α ) ) ∥ x − x ∗ ∥ 2 + ( η 2 − 2 η α + ( 2 η − α ) ) ∥ ∇ f ( x ) ∥ 2 = ( 1 − η α ) 2 ∥ x − x ∗ ∥ 2 = λ 2 ∥ x − x ∗ ∥ 2 \begin{aligned}
\|x-x^*-\eta \nabla f(x)\|^2&=\|x-x^*\|^2+\eta^2\|\nabla f(x)\|^2-2\eta \nabla f(x)^T(x-x^*)\\
&\leq \left(1-2\eta\frac{\alpha(\frac{2}{\eta}-\alpha)}{\alpha+(\frac{2}{\eta}-\alpha)}\right)\|x-x^*\|^2+\left(\eta^2-\frac{2\eta}{\alpha+(\frac{2}{\eta}-\alpha)}\right)\|\nabla f(x)\|^2\\
&=(1-\eta \alpha)^2\|x-x^*\|^2\\
&=\lambda^2\|x-x^*\|^2
\end{aligned}
∥ x − x ∗ − η ∇ f ( x ) ∥ 2 = ∥ x − x ∗ ∥ 2 + η 2 ∥ ∇ f ( x ) ∥ 2 − 2 η ∇ f ( x ) T ( x − x ∗ ) ≤ ( 1 − 2 η α + ( η 2 − α ) α ( η 2 − α ) ) ∥ x − x ∗ ∥ 2 + ( η 2 − α + ( η 2 − α ) 2 η ) ∥ ∇ f ( x ) ∥ 2 = ( 1 − η α ) 2 ∥ x − x ∗ ∥ 2 = λ 2 ∥ x − x ∗ ∥ 2
如果2 α + β < η < 2 β \frac{2}{\alpha+\beta}<\eta<\frac{2}{\beta} α + β 2 < η < β 2 α ≥ β \alpha\geq\beta α ≥ β
由引理3和式(8)可得
∥ x ˉ ( k ) − x ∗ ∥ ≤ λ ∥ x ˉ ( k − 1 ) − x ∗ ∥ + η ∥ g ( k − 1 ) − h ( k − 1 ) ∥ ≤ λ ∥ x ˉ ( k − 1 ) − x ∗ ∥ + ( η β / n ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ ( 9 ) \begin{aligned}
\|\bar x(k)-x^*\|&\leq \lambda \|\bar x(k-1)-x^*\|+\eta \|g(k-1)-h(k-1)\|\\
&\leq \lambda \|\bar x(k-1)-x^*\|+(\eta\beta/\sqrt{n}) \|x(k-1)-1_n\bar x(k-1)\|
\end{aligned}\qquad(9)
∥ x ˉ ( k ) − x ∗ ∥ ≤ λ ∥ x ˉ ( k − 1 ) − x ∗ ∥ + η ∥ g ( k − 1 ) − h ( k − 1 ) ∥ ≤ λ ∥ x ˉ ( k − 1 ) − x ∗ ∥ + ( η β / n ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ ( 9 )
其中λ = max ( ∣ 1 − η α ∣ , ∣ 1 − η β ∣ ) \lambda =\max(|1-\eta \alpha|,|1-\eta \beta|) λ = max ( ∣ 1 − η α ∣ , ∣ 1 − η β ∣ )
第四步,看∥ x ( k ) − x ( k − 1 ) ∥ \|x(k)-x(k-1)\| ∥ x ( k ) − x ( k − 1 ) ∥
∥ h ( k − 1 ) ∥ = ∥ ∇ f ( x ˉ ( k − 1 ) ) ∥ ≤ β ∥ x ˉ ( k − 1 ) − x ∗ ∥ . \|h(k-1) \|=\|\nabla f(\bar x(k-1)) \|\leq \beta\|\bar x(k-1)-x^* \|.
∥ h ( k − 1 ) ∥ = ∥ ∇ f ( x ˉ ( k − 1 ) ) ∥ ≤ β ∥ x ˉ ( k − 1 ) − x ∗ ∥ .
结合式(9)的方法
∥ s ( k − 1 ) ∥ ≤ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ 1 n g ( k − 1 ) − 1 n h ( k − 1 ) ∥ + ∥ 1 n h ( k − 1 ) ∥ ≤ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + β n ∥ x ˉ ( k − 1 ) − x ∗ ∥ . \begin{aligned}
\|s(k-1)\|&\leq \|s(k-1)-1_ng(k-1) \|+\|1_ng(k-1)-1_n h(k-1) \|+\|1_n h(k-1)\|\\
&\leq \|s(k-1)-1_ng(k-1) \|+\beta\|x(k-1)-1_n \bar x(k-1) \|+\beta \sqrt{n}\|\bar x(k-1)-x^*\|.
\end{aligned}
∥ s ( k − 1 ) ∥ ≤ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ∥ 1 n g ( k − 1 ) − 1 n h ( k − 1 ) ∥ + ∥ 1 n h ( k − 1 ) ∥ ≤ ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + β n ∥ x ˉ ( k − 1 ) − x ∗ ∥ .
因此
∥ x ( k ) − x ( k − 1 ) ∥ = ∥ W x ( k − 1 ) − x ( k − 1 ) − η s ( k − 1 ) ∥ = ∥ ( W − I ) ( x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ) − η s ( k − 1 ) ∥ ≤ 2 ∥ ( x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ) ∥ + η ∥ s ( k − 1 ) ∥ ≤ η ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ( η β + 2 ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + η β n ∥ x ˉ ( k − 1 ) − x ∗ ∥ . \begin{aligned}
\|x(k)-x(k-1) \|&=\|Wx(k-1)-x(k-1)-\eta s(k-1) \|\\
&=\|(W-I)(x(k-1)-1_n\bar x(k-1))-\eta s(k-1) \|\\
&\leq 2\|(x(k-1)-1_n\bar x(k-1))\|+\eta\|s(k-1) \|\\
&\leq \eta\|s(k-1)-1_ng(k-1) \|\\
&\quad+(\eta\beta+2)\|x(k-1)-1_n \bar x(k-1) \|+\eta\beta \sqrt{n}\|\bar x(k-1)-x^*\|.
\end{aligned}
∥ x ( k ) − x ( k − 1 ) ∥ = ∥ W x ( k − 1 ) − x ( k − 1 ) − η s ( k − 1 ) ∥ = ∥ ( W − I ) ( x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ) − η s ( k − 1 ) ∥ ≤ 2 ∥ ( x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ) ∥ + η ∥ s ( k − 1 ) ∥ ≤ η ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + ( η β + 2 ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + η β n ∥ x ˉ ( k − 1 ) − x ∗ ∥ .
将上式代入(6)得到
∥ s ( k ) − 1 n g ( k ) ∥ ≤ ( σ + β η ) ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ( η β + 2 ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + η β 2 n ∥ x ˉ ( k − 1 ) − x ∗ ∥ ( 10 ) \begin{aligned}
\|s(k)-1_n g(k)\|&\leq (\sigma+\beta \eta)\|s(k-1)-1_n g(k-1) \|\\
&\quad +\beta(\eta \beta+2)\|x(k-1)-1_n \bar x(k-1) \|+\eta\beta^2 \sqrt{n}\|\bar x(k-1)-x^*\|
\end{aligned}\qquad (10)
∥ s ( k ) − 1 n g ( k ) ∥ ≤ ( σ + β η ) ∥ s ( k − 1 ) − 1 n g ( k − 1 ) ∥ + β ( η β + 2 ) ∥ x ( k − 1 ) − 1 n x ˉ ( k − 1 ) ∥ + η β 2 n ∥ x ˉ ( k − 1 ) − x ∗ ∥ ( 1 0 )
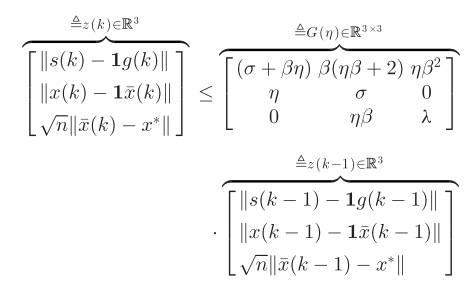
结合(7)(9)和(10)得到
因为z ( k ) z(k) z ( k ) G ( η ) G(\eta) G ( η )
z ( k ) ≤ G ( η ) k z ( 0 ) . z(k)\leq G(\eta)^kz(0).
z ( k ) ≤ G ( η ) k z ( 0 ) .
因为G ( η ) G(\eta) G ( η ) G ( η ) 2 G(\eta)^2 G ( η ) 2 G ( η ) k G(\eta)^k G ( η ) k O ( ρ ( G ( η ) ) k ) O(\rho(G(\eta))^k) O ( ρ ( G ( η ) ) k ) z ( h ) z(h) z ( h ) ρ ( G ( η ) ) k \rho(G(\eta))^k ρ ( G ( η ) ) k