写在前面
最近在看一些分布式优化的文章,但是大部分文章都是用的离散时间算法。我之前一直研究的是连续时间一致性(consensus)控制问题,现在想把离散时间控制拾起来。
这篇文章前半部分讲解连续和离散系统的一致性算法,互相做个对比,加深一下印象和理解;后半部分回顾在算法证明中会用到的矩阵理论的基本知识。
下面进入文艺复兴环节,让我们回顾一下最经典的一致性算法和矩阵理论的基本知识吧。
一致性算法
考虑状态xi∈Rm,图G=(V,E)和单积分器系统
x˙i=ui,i∈V.
连续时间
首先,给出连续时间一致性算法:
x˙i=−j∈Ni∑aij(xi−xj),i∈V,
写成矩阵形式为
x˙=−(L⊗Im)x,
其中A=[aij]∈Rn×n是邻接矩阵(adjacency matrix),如果(j,i)∈E,那么aij>0,否则aij=0;L=[lij]∈Rn×n是拉普拉斯矩阵(Laplacian matrix),满足
lii=j=1,j=i∑naij,lij=−aij,i=j。
离散时间
然后,给出离散时间一致性算法:
xi,k+1=j∈Ni∑dijxi,k,i∈V,
写成矩阵形式为
xk+1=(D⊗Im)xk,
其中k∈N是离散时间指数(discrete-time index);D=[dij]∈Rn×n是行随机矩阵(row-stochastic matrix),满足dii>0对所有i∈V成立,如果(j,i)∈E,那么dij>0,否则dij=0。
Vicsek模型是离散时间一致性算法的特例,该模型中如果(j,i)∈E,那么令dij=1+∣Ni∣1,∣Ni∣表示智能体i的邻居(neighbor)个数。但是Vicsek模型不一定能保证为双随机矩阵(doubly-stochastic matrix)。已知L的情况下,令D=e−L虽然可以得到双随机矩阵,但是无法保证分布式实现。
想要得到满足前面条件的双随机矩阵,一种简单的办法是:如果(j,i)∈E,那么令dij=1/g,dii=1−∑j=idij,其中g>n。
一致性证明
无论对于连续时间或是离散时间系统,状态x都可以写成关于t或k的函数,即
x(t)=(e−Lt⊗Im)x(0),
或者
xk=(Dk⊗Im)x0。
下面需要一致集S={x∈Rnm∣x1=⋯=xn}是吸引(attractive)的正不变(positive invariant)集,即满足
t→∞lime−Lt=k→∞limDk=1ncT,
才有limt→∞x(t)=limk→∞xk=(1ncT⊗Im)x(0)。
连续时间
定理1 (Lemma 2.6 ):拉普拉斯矩阵L∈Rn×n对应的e−Lt,∀t≥0是主对角元大于0的行随机矩阵。另外,Rank(L)=n−1当且仅当L有单个0特征根。此外,若L有单个0特征根,且LT关于0特征根的标准化特征向量为c,即
1nTc=1,LTc=0,
那么e−Lt→1ncT,当t→∞。
证明:由于L是方阵,将−L特征分解(谱分解)得到−L=PJP−1,其中P=[p1,⋯,pn]∈Rn×n,J=diag(0,−λ2,⋯,−λn)。不失一般性,我们令p1=1n对应0特征根,而λ2,⋯,λn都大于0。
由矩阵指数的性质,易知e−Lt=PeJtP−1。故e−Lt有特征根1对应特征向量1n,即e−Lt1n=1n,因此是行随机矩阵。此外,可以看出eJt→diag(1,0,⋯,0),当t→∞,即
PeJtP−1→[1np2⋯pn]⎣⎢⎢⎢⎡10⋮000⋮0⋯⋯⋱⋯00⋮0⎦⎥⎥⎥⎤⎣⎢⎢⎢⎡cTν2T⋮νnT⎦⎥⎥⎥⎤,
当t→∞。故e−Lt→1ncT,当t→∞,又因为e−Lt行随机,即e−Lt1n=1n(cT1n)=1n,故1nTc=1。
引理1 (Lemma C.2):给定矩阵A∈Rn×n和特征根λ∈C,假设x,y满足(i)Ax=λx,(ii)ATy=λy,(iii)xTy=1。如果∣λ∣=ρ(A)>0,其中ρ(A)为A的谱半径,且λ是唯一具有最大模数(maximum modulus)的特征根,那么limm→∞(λ−1A)m→xyT。
A∈Rn×n是可约矩阵(reducible),即要么为全0矩阵,要么存在置换矩阵P∈Rn×n使得PTAP为分块上三角阵(block upper triangular form)。 A∈Rn×n是非负矩阵(nonnegative),即所有元素都大于等于0。
命题1 (Lemma C.3):方阵A∈Rn×n是不可约的当且仅当与矩阵A对应的有向图Γ(A)是强连通的。
引理2 (Lemma C.4):如果A∈Rn×n是非负的不可约(irreducible)矩阵,那么ρ(A)是A的一个特征根,且存在一个非0特征向量x≥0(即非负)使得Ax=ρ(A)x。
接下来需要证明c≥0且c是L关于0的左特征向量,即LTc=0。由引理1和引理3可得,c是(e−L)T的关于1的特征向量,再由下章的定理1.1,c是LT关于0的特征向量。由引理2可知,c≥0。L是不可约矩阵可由强连通性保证,下面的引理3证明L的单个0特征根性质。
一般来说,L有至少一个0特征根,而圆盘定理(Gershgorin's disc theorem)只能确保L的根都位于右半平面或虚轴上,但无法保证0特征根只有一个。事实上,当图G不连通时,可能有多个0特征根,且0特征根的个数等于图的连通分量个数。
引理3 (Lemma 2.4):给定矩阵A∈Rn×n,其中aii≤0,aij≥0,∀i=j,且∑j=1naij=0对任意i成立,那么A有至少一个0特征根和相关的特征向量1n,其他非0特征根都位于右半开平面。此外,A有唯一的0特征根,当且仅当A对应的有向图Γ(A)有一个有向生成树(directed spanning tree)。
离散时间
引理4 (Lemma 2.16):如果一个非负矩阵A=[aij]∈Rn满足∑j=1ndij=μ>0,那么μ是A关于特征向量1n的一个特征根,且ρ(A)=μ,其中ρ(⋅)表示谱半径。另外,特征根μ的代数重数(algebraic multiplicity)为1,当且仅当A对应的有向图Γ(A)有一个有向生成树。此外,如果dii>0,i=1,⋯,n,(i) 那么∣λ∣<μ对任意λ=μ成立,(ii) 如果有向图Γ(A)有一个有向生成树,那么μ是唯一具有最大模数的特征根。
证明:矩阵A行和为μ,即A1n=μ1n。再由非负性和圆盘定理,ρ(A)≤μ。故μ是A关于特征向量1n的一个特征根,且ρ(A)=μ。
(充分性) 若A对应的有向图Γ(A)有一个有向生成树,令B=A−μI,则B满足引理3的条件。B的0根的代数重数为1,自然A的μ根代数重数也为1。
(必要性) (逆否) 若A对应的有向图Γ(A)没有向生成树,令B=A−μI,则B有不止一个0根,A的μ根代数重数大于1。
定理2 (Perron-Frobenius theorem):如果A∈Rn×n非负且不可约,那么 (i) ρ(A)>0,(ii) ρ(A)是A的一个特征根,(iii) 存在正向量x使得Ax=ρ(A)x,(iv) ρ(A)是A的一个代数重数为1(几何重数也为1)的特征根。
一个行随机矩阵A是不可分解且非周期的(indecomposable and aperiodic, SIA),如果limk→∞Ak=1nνT,即极限存在且每一行都相同。
定理3 (Lemma 2.19):给定行随机矩阵A∈Rn×n。如果A有代数重数为1的特征根λ=1,且其他特征根满足∣λ∣<1,那么A是SIA。特别地,limm→∞Am→1nνT,其中ATν=ν且1nTν=1。此外,ν的每一个元素非负。
证明:SIA和左特征向量可由引理1直接推出。而A和AT特征根相同(下章的结论2.1),由引理2可知特征根1对应的特征向量非负。
矩阵理论
主要介绍了特征值、特征向量、特征多项式、代数重数、几何重数以及重要的性质。
特征值和特征向量
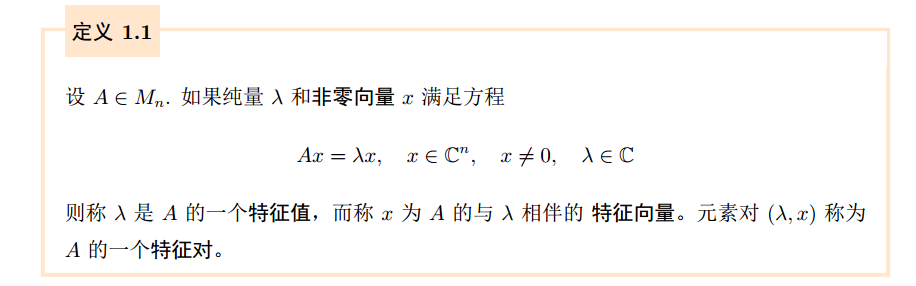
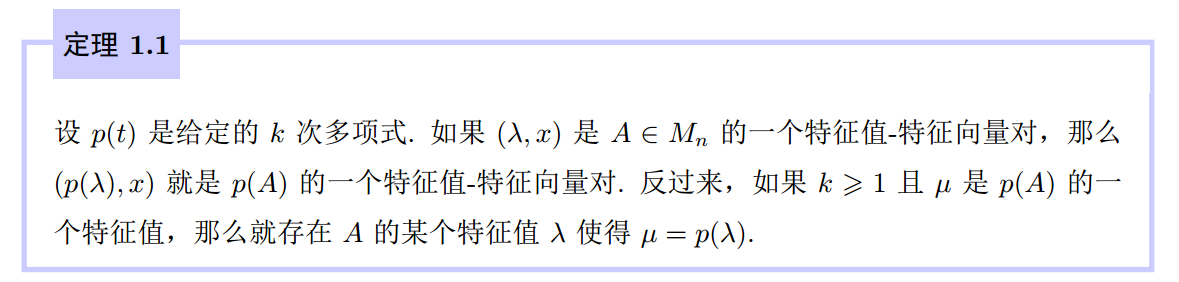
这个定理前面有用到,如果0是L的一个特征根,那么e0=1也是e−L的一个特征根,且它们相应的特征向量都为1n,反之也一样。
定义σ(A)为矩阵A的特征根集。有几个重要性质:
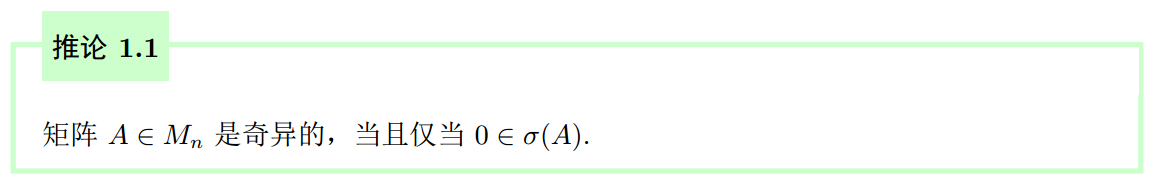
n 阶方阵A是非奇异方阵的充要条件是A可逆,即可逆方阵就是非奇异方阵。以下命题等价:
- 一个矩阵非奇异当且仅当它的行列式不为零。
- 一个矩阵非奇异当且仅当它代表的线性变换是个自同构。
- 一个矩阵半正定当且仅当它的每个特征值大于或等于零。
- 一个矩阵正定当且仅当它的每个特征值都大于零。
- 一个矩阵非奇异当且仅当它的秩为n(满秩)。
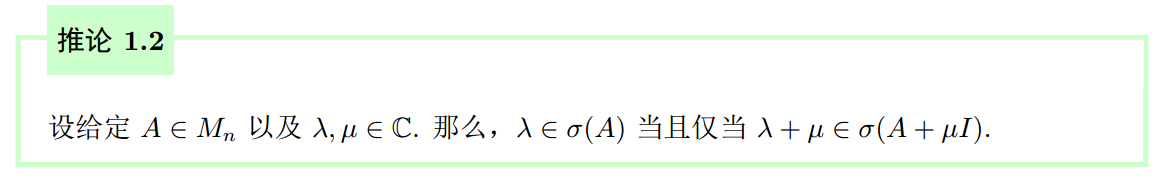
证明:如果λ∈σ(A),则存在一个非零向量x,使得Ax=λx,从而(A+μI)x=Ax+μx=λx+μx=(λ+μ)x。于是λ+μ∈σ(A+μI)。反过来,如果λ+μ∈σ(A+μI),则存在非零向量y,使得Ay+μy=(A+μI)y=(λ+μ)y=λy+μy。于是Ay=λy, 从而λ∈σ(A)。
特征多项式
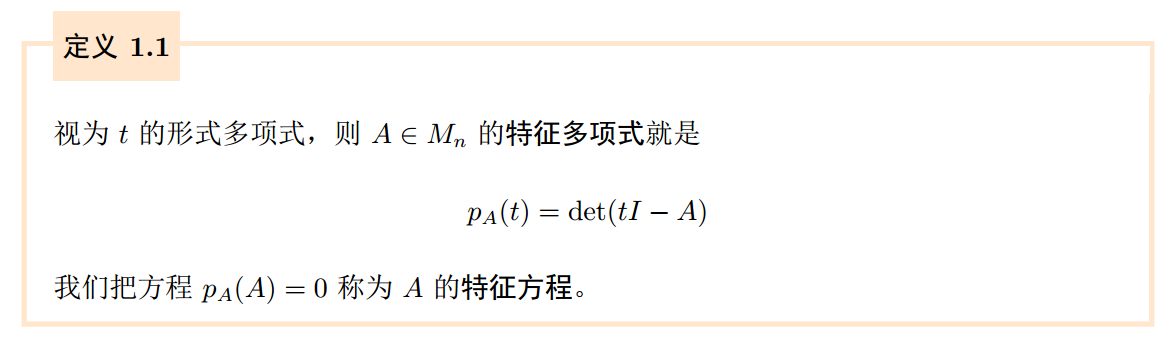
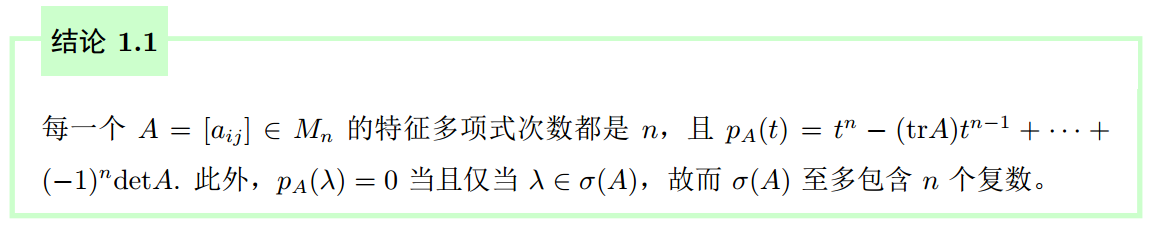
证明:
- 多项式次数最高的两项和常数项已经给出,而其他求和项包含非对角因子−aij,故次数不会大于n−2,因为t−aij和t−ajj不是因子。
- pA(λ)=0⇔det(λI−A)=0⇔(λI−A)x=0,x=0⇔λ∈σ(A)
- 次数为n⩾1的多项式至多有n个不同零点。
pA(t)的零点之和是A的迹tr(A),而零点之积则是A的行列式det(A)。
代数重数
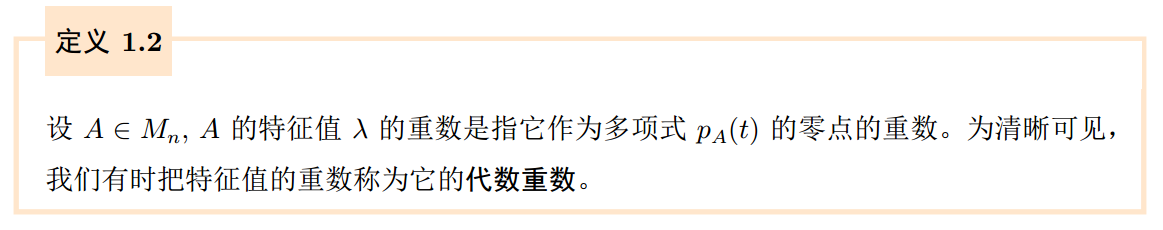
λ的代数重数是特征方程里面有几个根是λ。
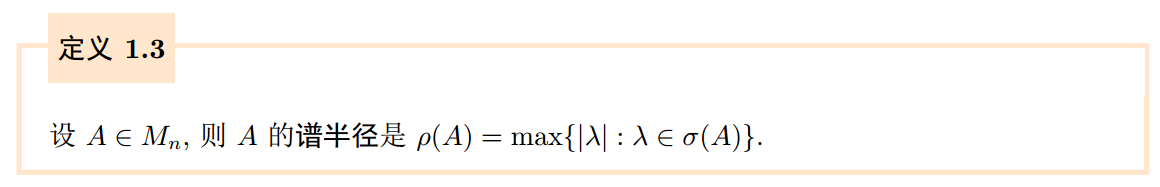
矩阵的谱半径(spectral radius)是模最大特征根对应的模数。
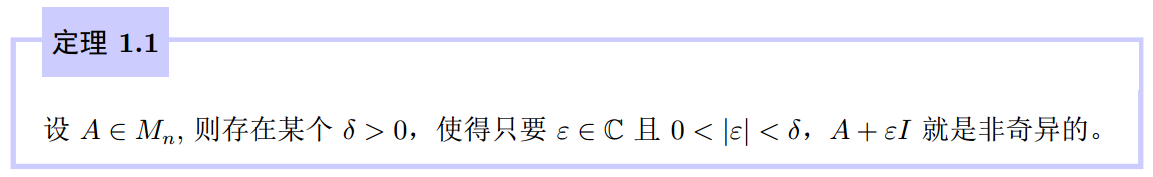
上述定理表明,一个奇异的复矩阵总可以稍加平移使之成为非奇异的。
几何重数
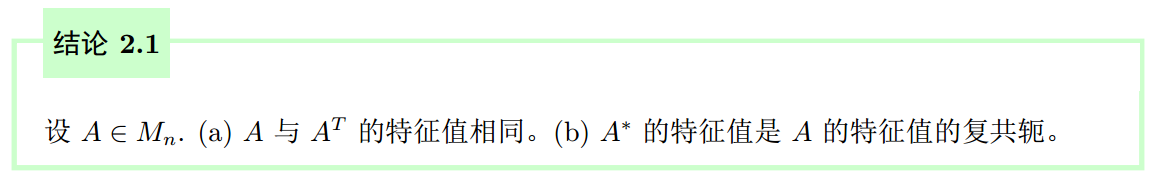
证明:由于det(tI−AT)=det(tI−A)T=det(tI−A), 我们有pAT(t)=pA(t), 所以有pAT(λ)=0 当且仅当 pA(λ)=0。 类似地,det(tˉI−A∗)=det[(tI−A)∗]=det(tI−A), 所以pA∗(tˉ)=pA(t), 又pA∗(λˉ)=0当且仅当pA(λ)=0。
如果x,y∈Cn两者都是A∈Mn的与特征值λ相伴的特征向量,那么x与y的任何非零的线性组合也是它的与λ相伴的特征向量 。实际上,与一个给定的λ∈σ(A)相伴的所有特征向量组成的集合与零向量合起来作成Cn的一个子空间,该子空间就是A−λI的零空间,就是齐次线性方程组(A−λI)x=0的解集,由秩的关系知其维数是 n−rank(A−λI)。该空间有个名字就是特征空间,下面给出特征空间的完整定义:
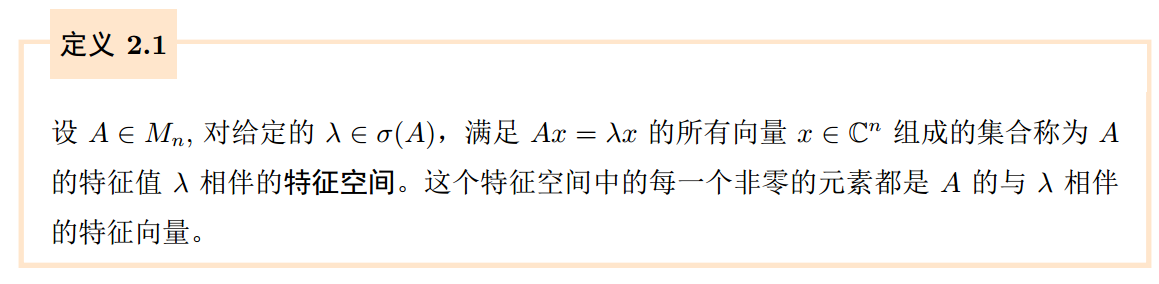
介绍完特征空间,就可以定义几何重数了,特征空间的维数即为几何重数。
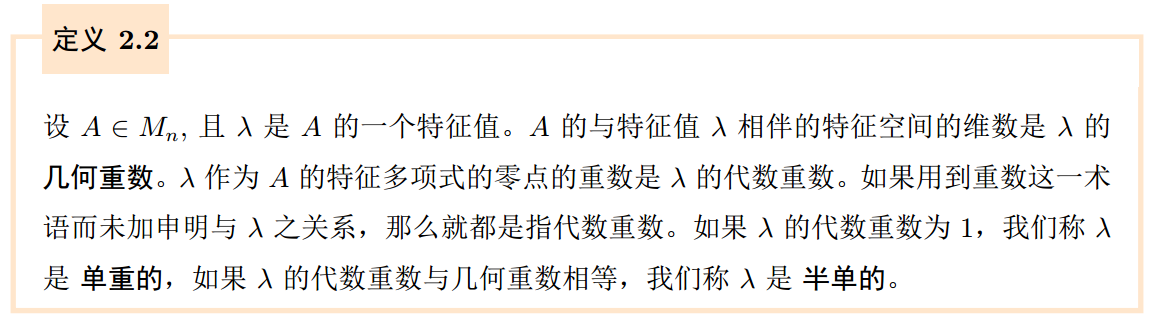
可以证明特征值的几何重数小于或者等于它的代数重数的。
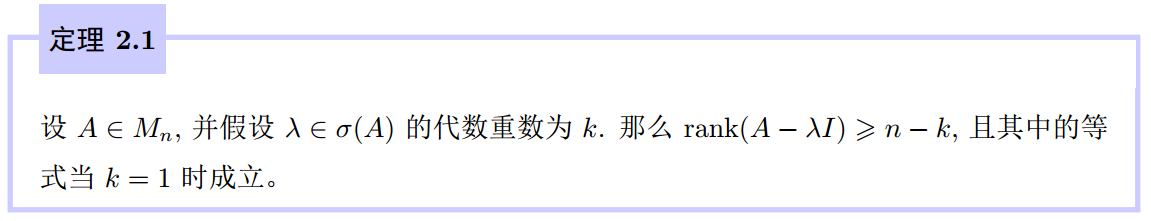
即,几何重数=n−rank(A−λI)≤k=代数重数。
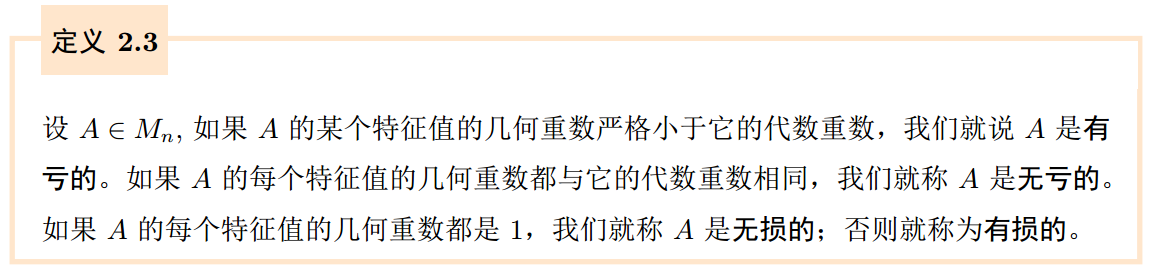
一个矩阵可对角化,当且仅当它是无亏的;它有完全不同的特征值,当且仅当它是无损的且是无亏的。考虑以下矩阵的特征值λ=1, 矩阵[1002],代数重数等于它的几何重数且都是 1, 它是无亏的,单位矩阵I2是无亏的且是有损的,矩阵[1011],几何重数是1, 代数重数是2,它是有亏的且是无损的。
尽管A与AT有相同的特征值,它们与给定特征值相伴的特征空间有可能是不同的。比如,矩阵A=[2034],那么A的与特征值2相伴的(一维)特征空间是由[10]生成的,而AT的与特征值2相伴的特征空间是由[100−3/2]生成的。
总结
- λ的代数重数是特征方程里面有几个根是λ。
- λ的几何重数是线性空间Ax=λx的维数。
- 代数重数大于等于几何重数,代数重数如果大于几何重数,那么原因在于这个矩阵的Jordan标准型里面有维数大于1的Jordan块。
- 强连通⇔有向生成树⇔不可约⇔最大模数特征根代数重数为1⇔相应特征向量非负
- 如果是行随机(行和为1),则上面条件⇔SIA⇔极限为1nνT,其中ν为左特征向量